Inzichten/Databeschikbaarheid
Slechte data repareer je niet met een betere koppeling!
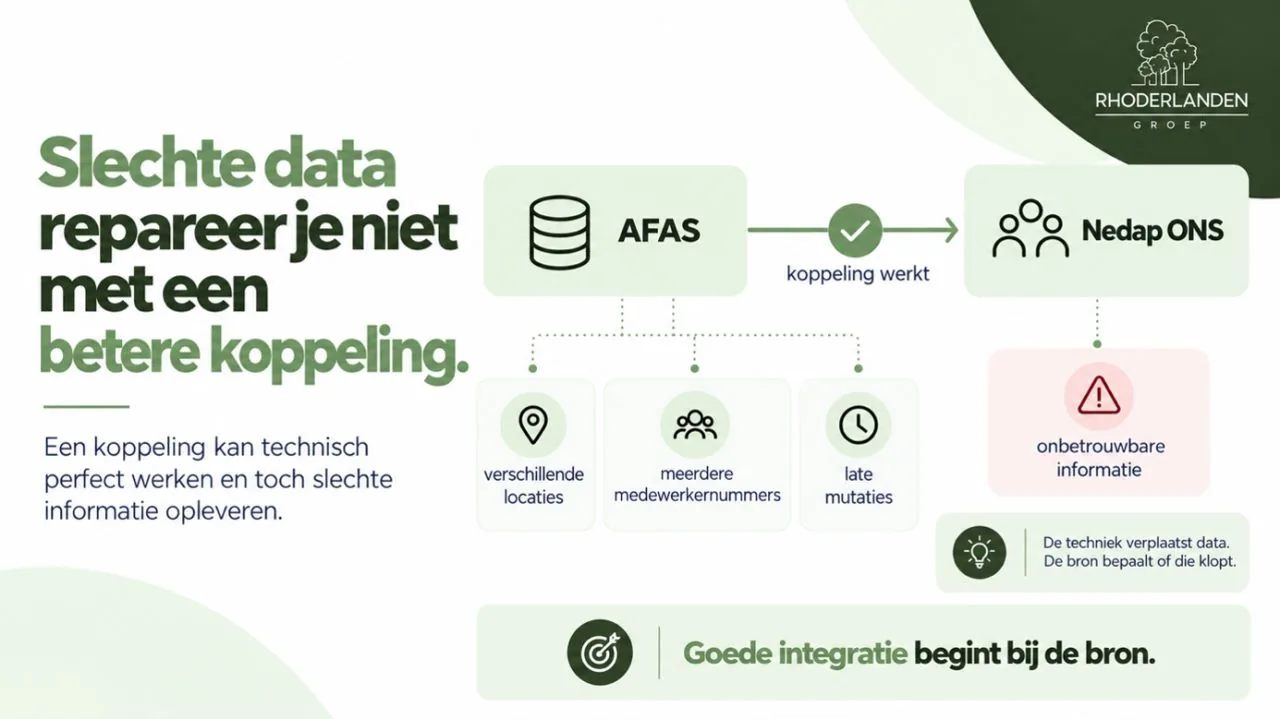
Een koppeling kan technisch perfect werken en toch slechte informatie opleveren.
Als integratieconsultant heb ik heel wat systemen met elkaar verbonden. ECD’s, financiële systemen, HR-systemen, datawarehouses en alles wat daar tussenin zit.
En één ding kom je dan vanzelf tegen: een koppeling kan technisch perfect werken en toch slechte informatie opleveren.
Alles groen, en toch niet goed
Stel dat medewerkersgegevens vanuit AFAS naar Nedap ONS worden gestuurd. De koppeling draait iedere nacht, er zijn geen foutmeldingen en technisch gezien is alles groen. Mooi.
Maar wat als een locatie in AFAS anders wordt vastgelegd dan in ONS? Wat als medewerkers onder verschillende medewerker nummers bekend zijn? Of als wijzigingen pas dagen later in het bronsysteem worden verwerkt?
Dan doet de koppeling precies wat we hem hebben gevraagd: hij transporteert de data keurig van A naar B. Alleen is de data zelf niet goed genoeg.
Sneller verspreiden lost niets op
Hetzelfde zie je bij productiegegevens die vanuit een ECD richting een financieel systeem als Exact gaan. Als aan de bron niet eenduidig wordt geregistreerd, definities verschillen of correcties niet goed worden verwerkt, lost een snellere of slimmere koppeling dat probleem niet op. Sterker nog: je verspreidt het probleem alleen sneller.
De vraag vóór de koppeling
Dat is volgens mij een belangrijk onderscheid. Bij integratievraagstukken kijken we al snel naar techniek: API’s, berichtenverkeer, mappings en foutmeldingen. Dat hoort erbij. Maar minstens zo belangrijk is de vraag wat er vóór die koppeling gebeurt.
Waar ontstaat de data? Wie registreert haar? Welke afspraken zijn er over definities? Wie is verantwoordelijk voor de kwaliteit? En wat gebeurt er als gegevens niet kloppen?
Begin bij de bron
Goede integratie begint daarom niet bij de koppeling, maar bij de bron.
De techniek kan data verplaatsen. Maar de techniek kan niet bepalen of die data ook klopt.
Geschreven doorRuben Kreuwel